Lázaro escribió:@lolerbober Lo primero de todo, gracias por contestar. Agradezco tu tiempo.
Tengo una IA local con Gemma (en LM y Bionic) y Qwen (en LM), tanto en Windows como en Linux, y pago ChatGPT + Gemini (porque me viene con el almacenamiento ampliado para Google Fotos, si no ni de coña xD), además de Claude y Antigravity en free. Ninguna ha podido conseguir lo que busco. Seguramente por lo que digo, es mi primer proyecto y voy pez.
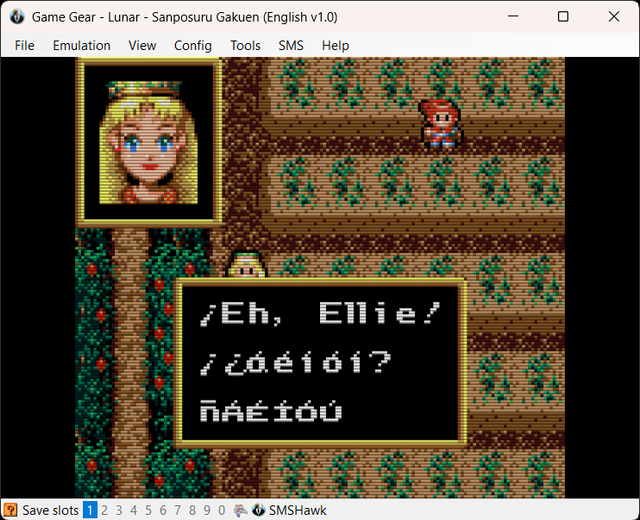
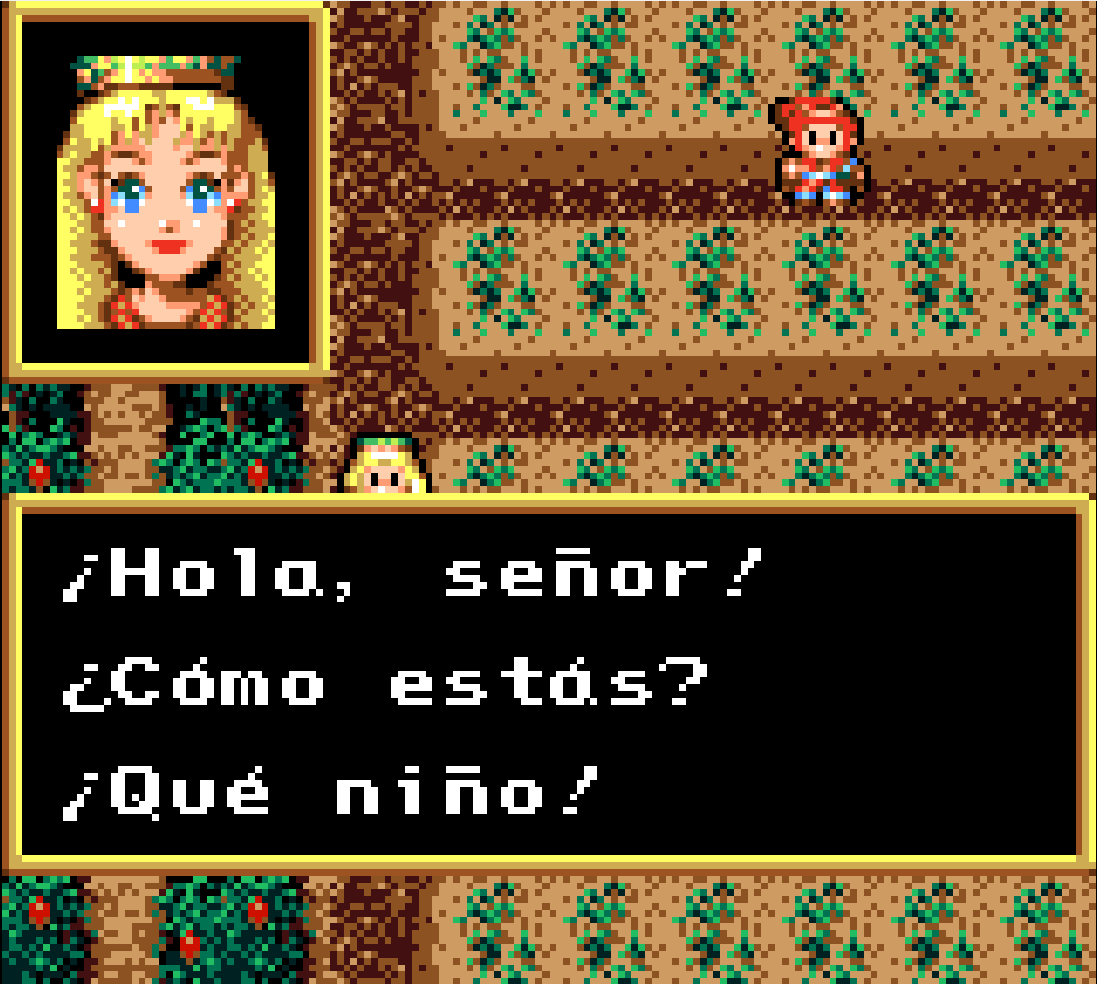
Si bien el problema de los textos ya está resuelto (voy por el capítulo 3, casi un 15% traducido), me ha salido un problema que no consigo solucionar. Al ampliar los textos, ahora hay npcs que dicen cosas que deberían decir otros. Parece ser que es algo de que los punteros se han movido pero no logramos encontrar cómo dicta el juego los punteros así que no se cómo asignar los textos a sus respectivos y originales NPC. Llevo casi tres días sin tocar el proyecto por esto mismo, no consigo ayuda ni con las IA consigo avanzar. Repito, seguramente porque no se términos ni manera de explicárselo, no creo que las 5 IA que tengo no puedan hacerlo

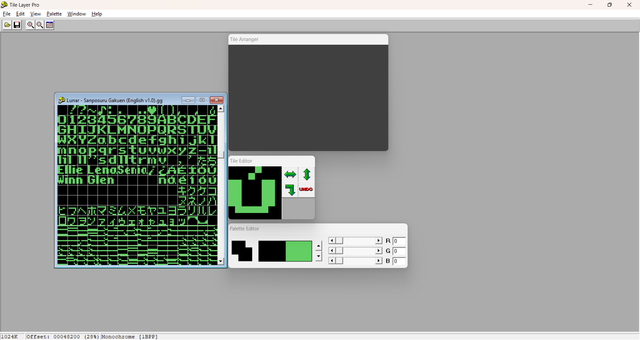
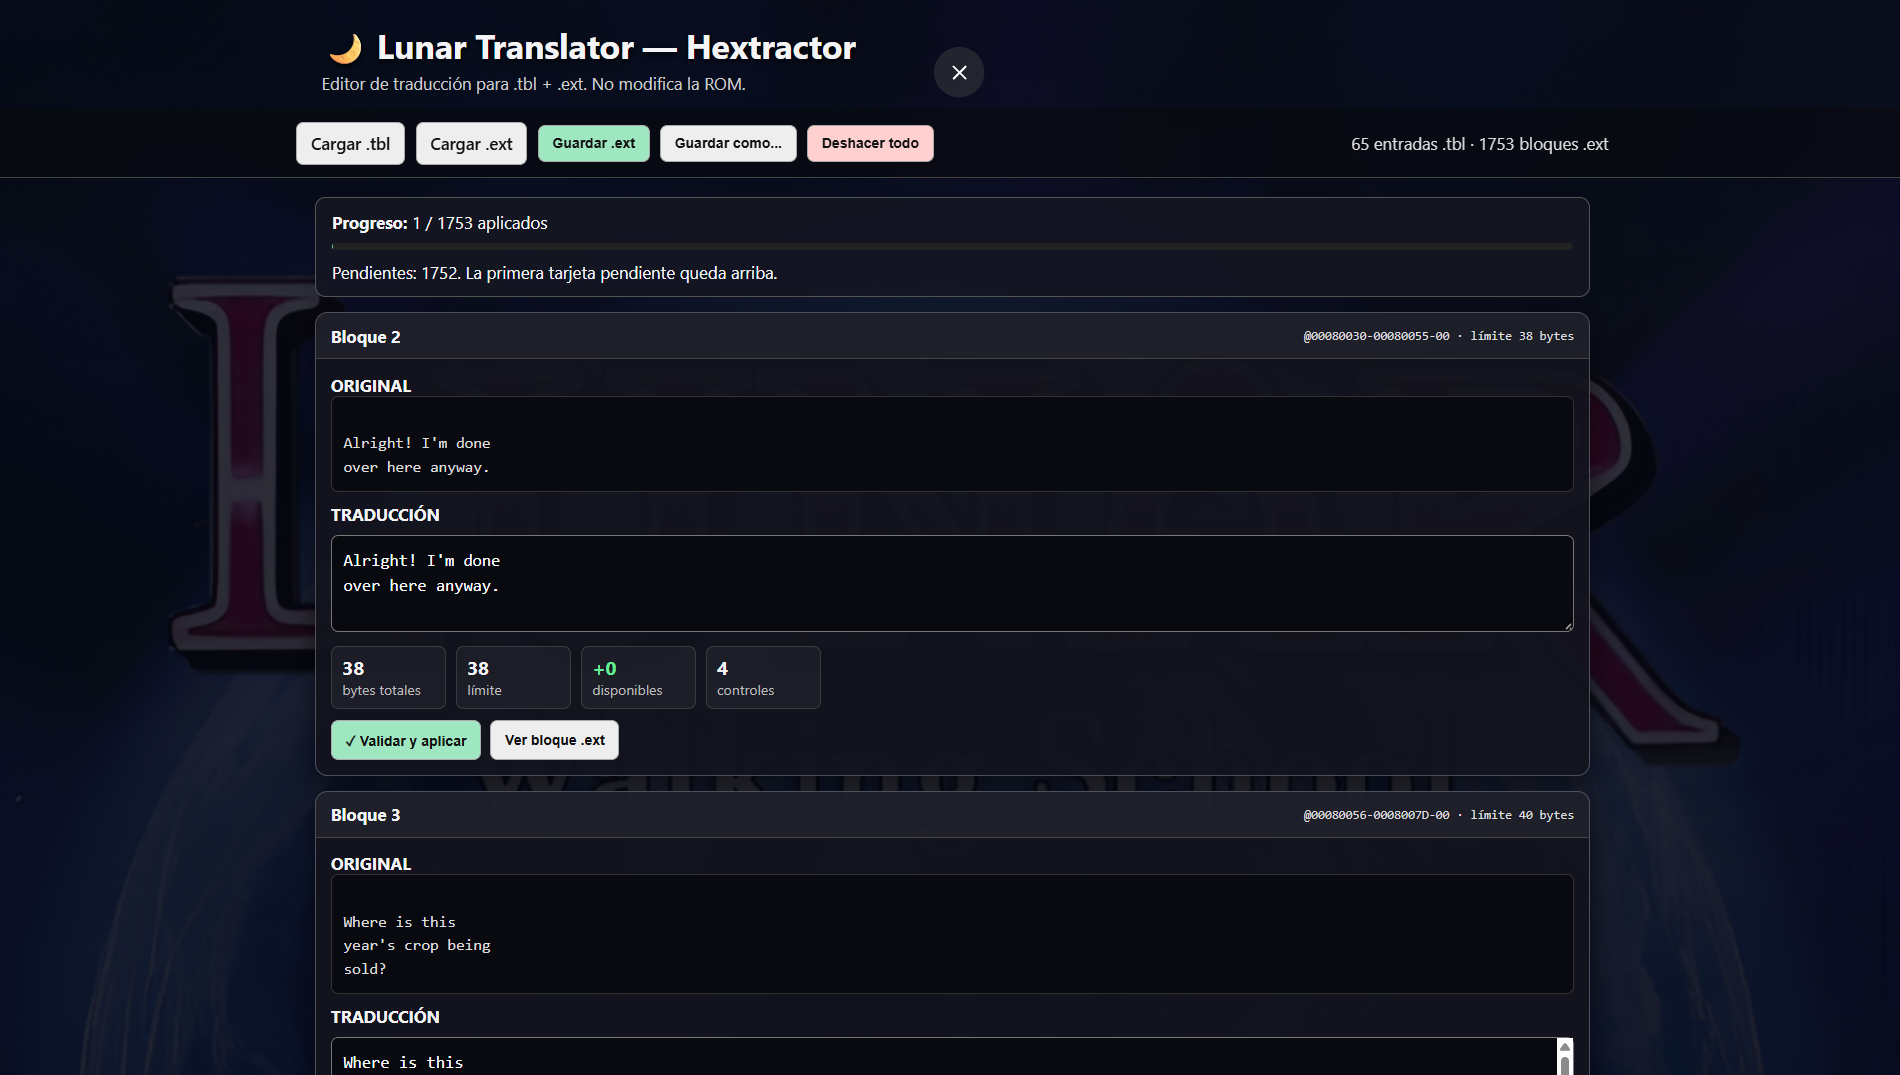
Lo que sí he conseguido son un montón de herramientas. Extractor de textos, para insertar traducciones, interfaz html para traducir respetando los códigos, otra de prueba con la api de deepl integrada (para traducir todo el texto del juego o por conversaciones y luego yo reviso y corrijo todo, tanto semánticamente como los posibles errores -se avanza mucho así-), formas de cambiar gráficos etc... pero ese problema en concreto no doy con él xD
(Yo tambien soy principiante y llevo poco en esto)
Por si te ayuda primero siempre sacate la Tabla de Punteros y dejar claro los offset de inicio y final ya que esto evita que te pases.
(un ejemplo)
1. El formato Little-Endian
En Game Gear, las direcciones de memoria de 2 bytes (16 bits) se escriben y leen al revés.
Si el texto de un NPC empieza en la dirección de memoria $4FA2, en el código del juego (en el editor hexadecimal) no vas a encontrar 4F A2. Lo vas a encontrar invertido: A2 4F.
2. Los Bancos de Memoria (Paginación)
La Game Gear no lee toda la ROM de golpe, lee fragmentos de 16KB (bancos). Por tanto, la dirección física en la ROM (offset) no es la misma que la dirección que usa el juego (CPU address). Normalmente, los textos se cargan en el espacio de memoria que va desde $4000 hasta $7FFF, o desde $8000 hasta $BFFF.
Cómo encontrar y arreglar los punteros (Paso a Paso)
Dile a tu compañero que haga esta prueba manual con un editor hexadecimal (como HxD) sobre la ROM original (sin traducir):
Paso 1: Localizar el inicio exacto de una frase original.
Busca en la ROM original dónde empieza la primera letra de lo que dice un NPC en concreto. Anota esa dirección hexadecimal (offset).
Ejemplo: Supongamos que el texto empieza en el offset 0x015A20.
Paso 2: Calcular la dirección de CPU (Game Gear).
Como los bancos son de 16KB (0x4000 en hexadecimal), hay que convertir ese offset en una dirección de CPU.
Fórmula rápida (suele funcionar en el 90% de juegos de GG): Toma los últimos 4 dígitos del offset (5A20) y si el primer número es menor de 4, súmale 4. Si es entre 4 y 7, déjalo igual o súmale 4 dependiendo del mapper, pero por norma general, el texto se mapeará en el rango $4000-$7FFF o $8000-$BFFF.
Asumamos que la dirección calculada de la CPU es $5A20.
Paso 3: Darle la vuelta (Little-Endian).
Coge $5A20 y sepáralo en dos bytes: 5A y 20.
Inviértelos: 20 5A.
Paso 4: Buscar el puntero en la ROM.
Busca los valores hexadecimales 20 5A en la ROM original.
Si encuentras esa pareja de bytes, ¡bingo! Has encontrado la Tabla de Punteros. Verás que justo al lado (dos bytes antes o después) están los punteros de las frases del NPC anterior y del siguiente.
Paso 5: Actualizar el puntero en la ROM traducida.
Cuando insertes la traducción, si esa misma frase ahora empieza en $5A80, tendrás que ir a esa tabla de punteros y sobrescribir el viejo 20 5A por el nuevo 80 5A.
Un detalle crítico que puede estar rompiendo el juego
Las herramientas automáticas de inserción a veces fallan por el límite de banco. Un banco de texto en Game Gear solo tiene 16KB de espacio. Si la traducción es tan larga que el texto "se sale" de esos 16KB, el puntero se romperá o leerá datos de otra parte. Si ocurre esto, hay que hacer repointing hacia zonas vacías de la ROM (espacio libre o free space), lo cual es más avanzado.
Te añado un prompt por si te ayuda :
Actúa como un experto programador especializado en ROM Hacking, ingeniería inversa y arquitectura de consolas de 8-bits, concretamente para Sega Game Gear (procesador Zilog Z80).

Estoy traduciendo un juego de Game Gear al español. Ya he extraído e insertado los textos, pero debido a la expansión del texto (el español ocupa más), las direcciones de los textos se han desplazado. Ahora los NPCs dicen frases incorrectas o el juego lee a mitad de una frase. El problema es que no he actualizado la Tabla de Punteros (Pointer Table).

Teniendo en cuenta las reglas de la arquitectura Z80 de Game Gear:

Los punteros son de 16 bits y usan formato Little-Endian (ej. la dirección $5A20 se escribe en hexadecimal como 20 5A).

La consola usa bancos de memoria (Memory Paging) de 16KB, por lo que la dirección física del archivo ROM (ROM Offset) no coincide con la dirección de memoria que lee la CPU (normalmente mapeada en $4000-$7FFF o $8000-$BFFF).

Necesito que me ayudes paso a paso con lo siguiente:

¿Cuál es la fórmula matemática exacta para convertir un "ROM Offset" físico (ej: 0x015A20) a una "CPU Address" de Game Gear, y cómo la convierto a Little-Endian para buscarla en el editor hexadecimal?

Una vez que localice la Tabla de Punteros, ¿cómo puedo programar un script sencillo en Python (ya que estoy usando herramientas personalizadas) que tome una lista de offsets originales, busque sus punteros en Little-Endian y los reemplace por los nuevos offsets generados tras la traducción?

Sé lo más técnico, metódico y didáctico posible. Pregúntame por los offsets hexadecimales concretos de mi ROM si necesitas hacer cálculos de ejemplo.